
AI 모델 경쟁에 또 불이 붙었다. 구글이 9월 2일(현지시간) 제미나이 3.8 플래시(Gemini 3.8 Flash)를 정식 출시했다. 3.7 플래시가 나온 지 불과 3주 만이다. 최근 6주 동안 세 번째 플래시 모델이다.
숫자만 바꾼 잦은 업데이트처럼 보일 수 있지만, 이번 모델의 방향은 꽤 분명하다. 구글은 짧은 질문에 빨리 답하는 경량 모델을 넘어 코딩과 자료 조사를 끝까지 수행하는 실무형 에이전트에 초점을 맞췄다.
100만 토큰 문맥과 6만 5천 토큰 출력
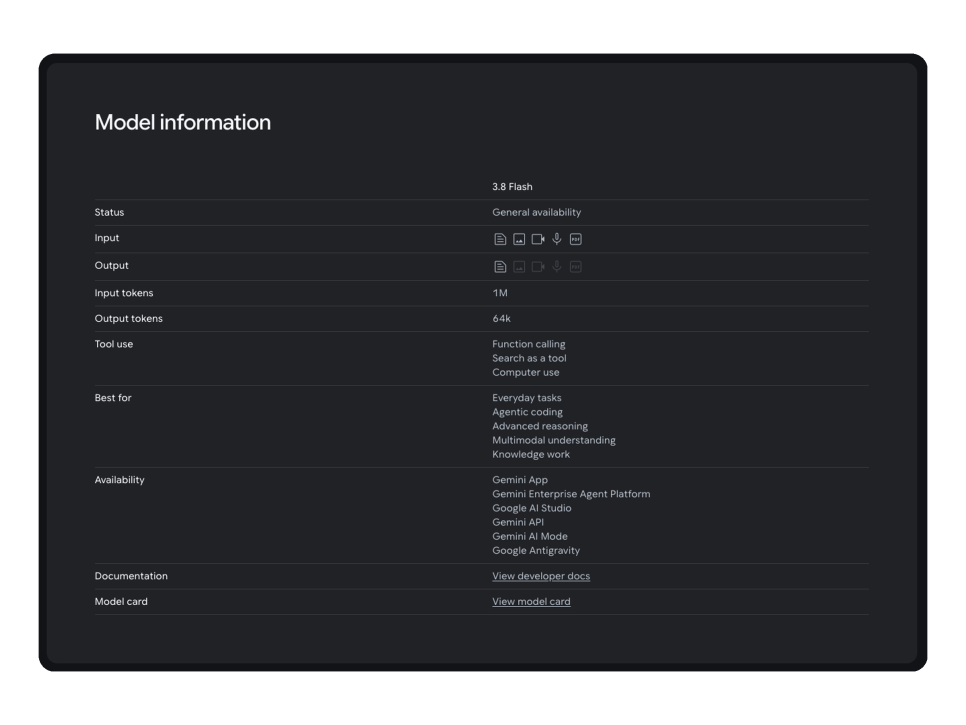
모델 ID는 gemini-3.8-flash다. 텍스트와 이미지, 영상, 오디오, PDF를 입력받고 텍스트를 출력한다. 입력 한도는 104만 8,576토큰, 최대 출력은 6만 5,536토큰이다.
검색 그라운딩, 코드 실행, 파일 검색, 함수 호출, 구조화 출력도 지원한다. 컴퓨터 사용 기능은 아직 프리뷰 단계다. 이미지와 음성 생성, 실시간 음성 대화용 Live API는 지원하지 않는다.
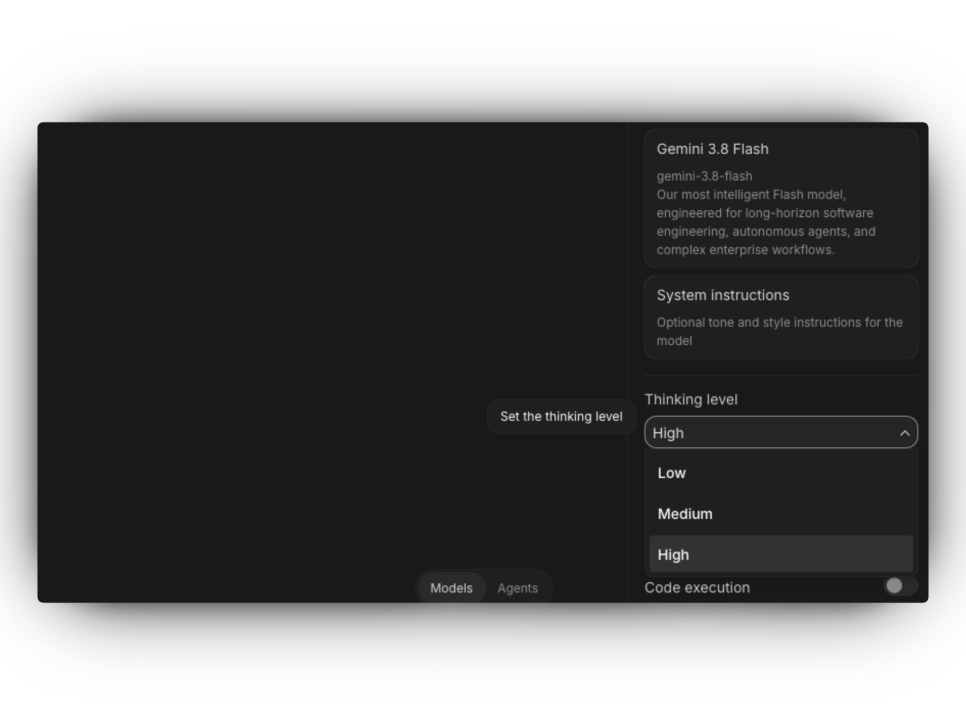
낮음, 중간, 높음의 세 단계로 추론 강도를 조절하는 점도 실제로 쓸 때 중요하다. 단순 분류와 요약은 낮게 설정해 지연과 비용을 줄일 수 있다. 여러 파일을 오가며 코드를 수정하거나 보고서를 만드는 일은 높게 설정하면 된다. 높은 단계에서는 추론과 도구 호출이 늘어 출력 토큰도 많아질 수 있다. 플래시라는 이름이 항상 가장 싼 결과를 뜻하지는 않는다는 얘기다.
벤치마크에서 드러난 강점과 약점
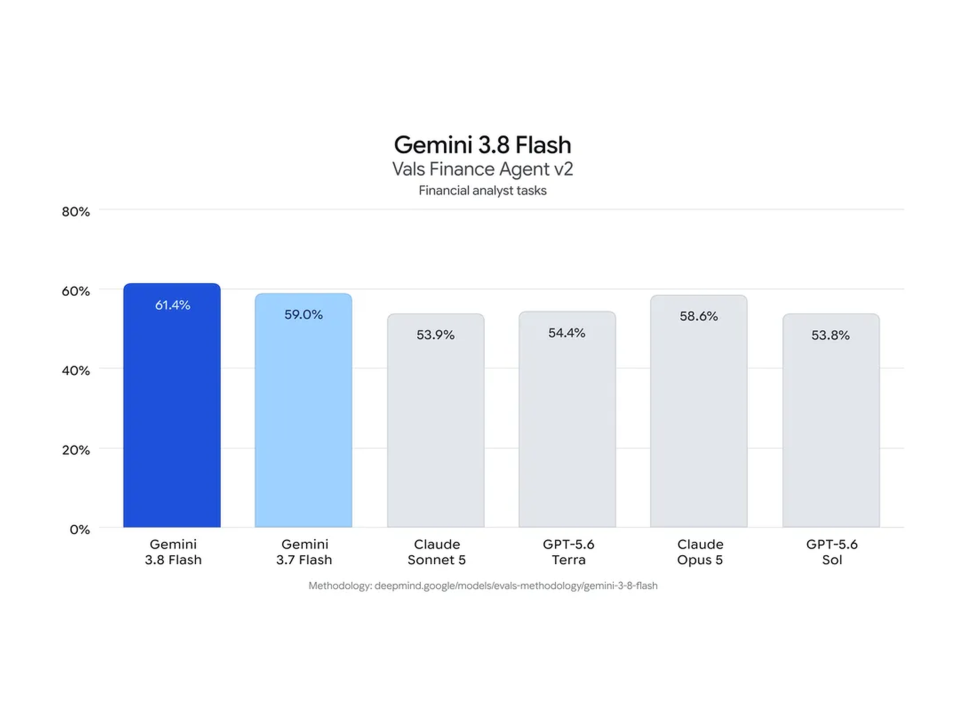
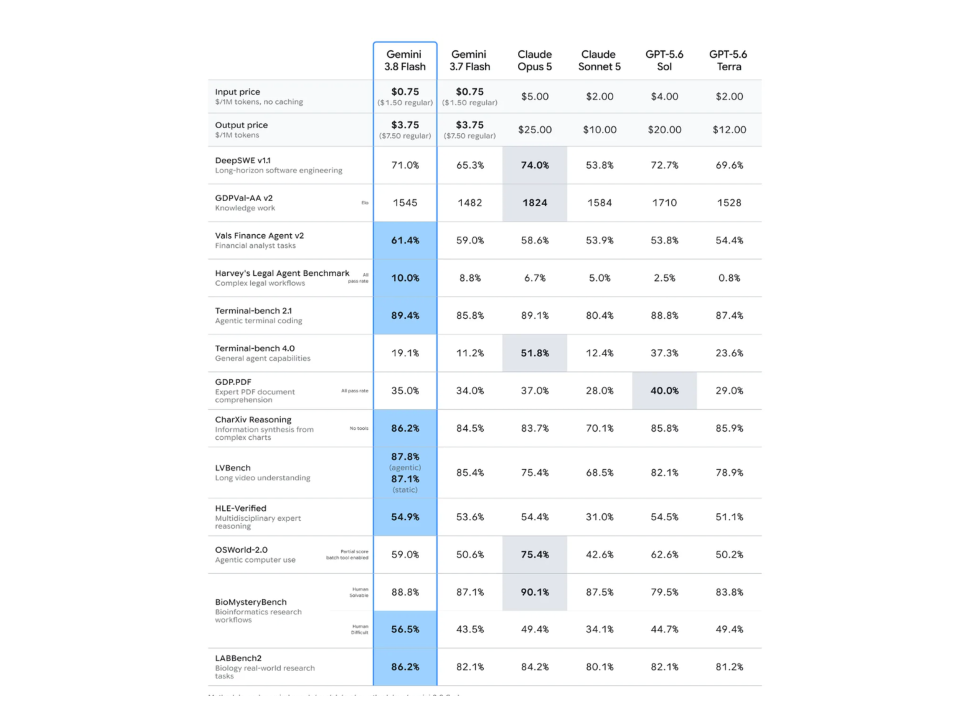
구글이 공개한 HLE-Verified 점수는 54.9%다. 과학과 인문학, 전문 지식을 섞은 다단계 추론 능력을 보는 평가다. 금융 분석용 Vals Finance Agent v2에서는 61.4%를 기록했다. 3.7 플래시(59.0%), Claude Opus 5(58.6%), GPT-5.6 Terra(54.4%)보다 높다.
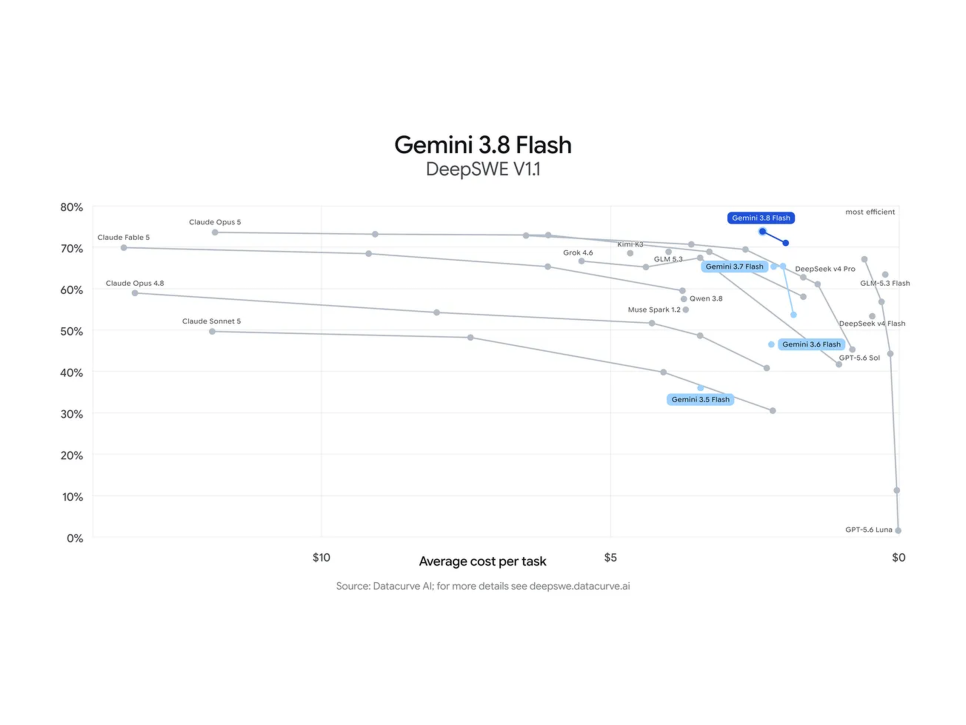
장기 소프트웨어 엔지니어링 평가 DeepSWE v1.1에서도 대형 프론티어 모델 대부분을 앞섰다는 것이 구글의 설명이다. 작업 비용은 더 낮았다고도 강조했다.
물론 제조사가 제시한 성적만으로 실사용 우위를 단정할 수는 없다. 그래도 독립 평가 기관 Artificial Analysis의 측정 결과도 크게 다르지 않다. 높은 추론 설정에서 Intelligence Index 59점, 출력 속도 초당 약 302토큰을 기록했다.
반면 첫 토큰이 나오기까지 13.39초가 걸렸다. 비교군 중앙값 3.02초보다 길고 평가 중 생성한 출력량도 많았다. 답변이 시작되면 빠르지만 어려운 작업을 오래 고민하고 길게 답하는 성향은 비용 계산에 넣어야 한다.
가격은 2027년에 두 배, 지금은 어디서 쓸 수 있나
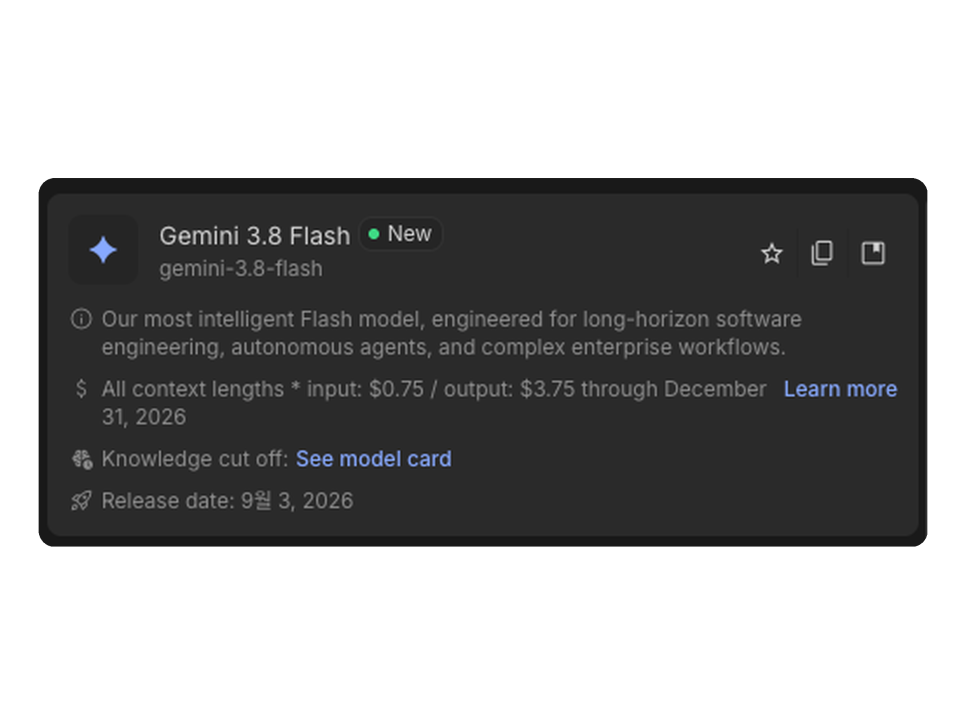
API 출시 기념 할인가는 100만 입력 토큰당 0.75달러, 출력 토큰당 3.75달러다. 3.7 플래시와 같은 가격이라 당장 모델을 교체해 시험하기에는 부담이 적다. 단, 이 가격은 2026년 12월 31일까지만 적용된다.
2027년 1월 1일부터 입력 1.50달러, 출력 7.50달러로 정확히 두 배 오른다. 장기 서비스의 원가를 따질 때 출시 가격만 기준으로 삼으면 계산이 크게 어긋난다.
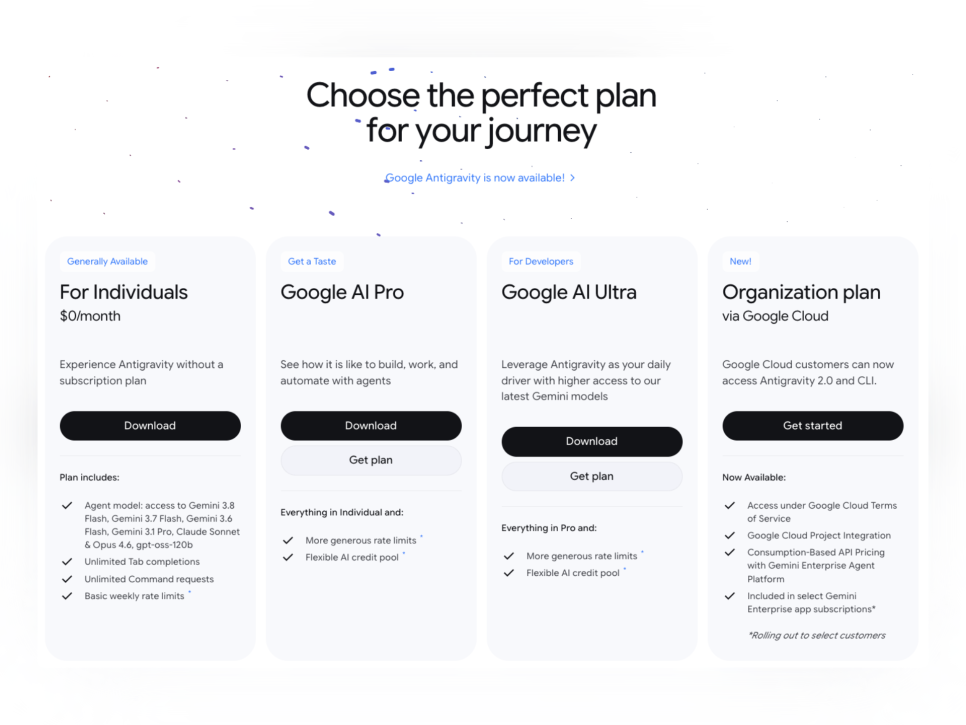
일반 이용자는 Google AI Pro와 Ultra 구독을 통해 제미나이 앱, 구글 검색 AI 모드, 구글 스프레드시트에서 이용할 수 있다. 개발자는 Gemini API와 Google AI Studio를 이용하면 된다. 물론 Android Studio와 Antigravity에서도 사용할 수 있다.
실제 업무에서 달라질 부분
제미나이 3.8 플래시에서 내가 가장 기대하는 건 사람이 중간 단계를 계속 이어 붙이지 않아도 된다는 점이다. 계약서와 표, 회의록을 함께 넣어 서로 맞지 않는 숫자를 찾고 보고서로 정리하는 작업이 한 예다. 큰 코드 저장소에서는 원인을 찾고 고친 뒤 테스트를 반복하는 일까지 맡길 수 있다.
파트너사 Glean의 내부 평가에서는 장시간 문서 작업 완료 건수가 3.7 플래시의 3배를 넘었다. 제조사와 협력하는 회사가 낸 수치다. 보편적인 성능으로 받아들이기보다 문서 작업에서 이만큼 좋아질 수 있다는 참고치로 보는 게 맞다.
실전 테스트는 엇갈렸다
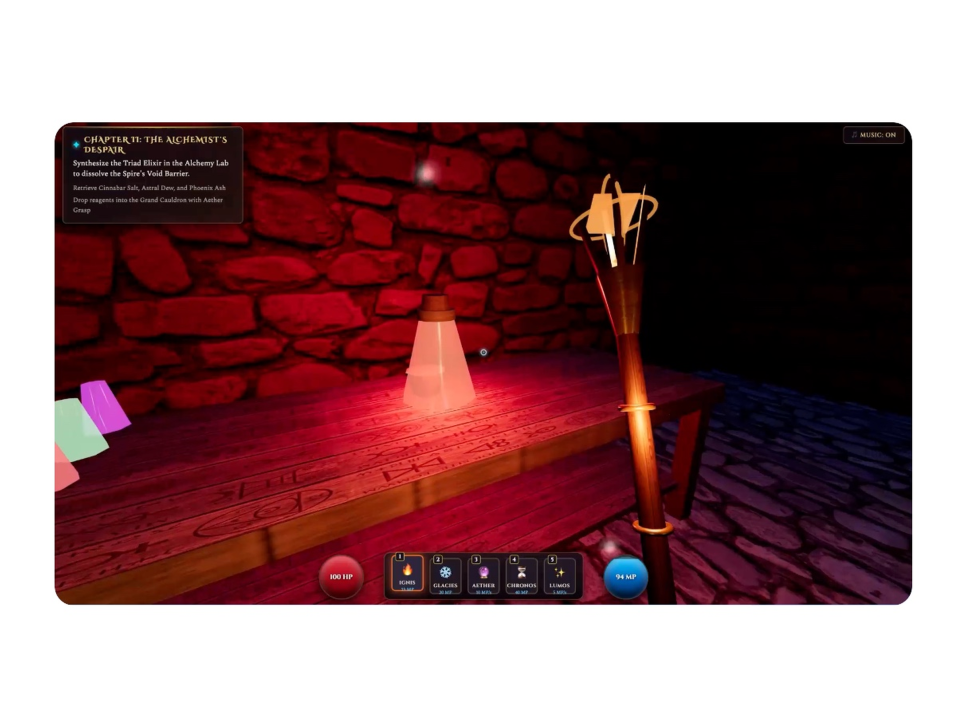
출시 직후 공개된 실전 테스트의 평가는 엇갈렸다. 국내 리뷰 영상에서는 복잡한 일정에서 회의 시간을 찾고 파이썬 코드에 숨긴 버그 5개를 모두 수정했다. 긴 시스템 로그도 지정한 JSON 형식으로 끝까지 변환했다. 반대로 해외 개발자 Matt Johnston의 앱 제작 테스트에서는 디아블로풍 게임이 95점을 받은 반면 3D 프린팅용 케이스는 48점에 그쳤다. 여러 도구를 연속 호출하는 자체 에이전트 평가는 같은 기준에서 9점에 머물렀다. 코드 초안을 빨리 만드는 능력과 검증 없이 완성품을 맡길 수 있는 신뢰성은 아직 같은 말이 아니다.
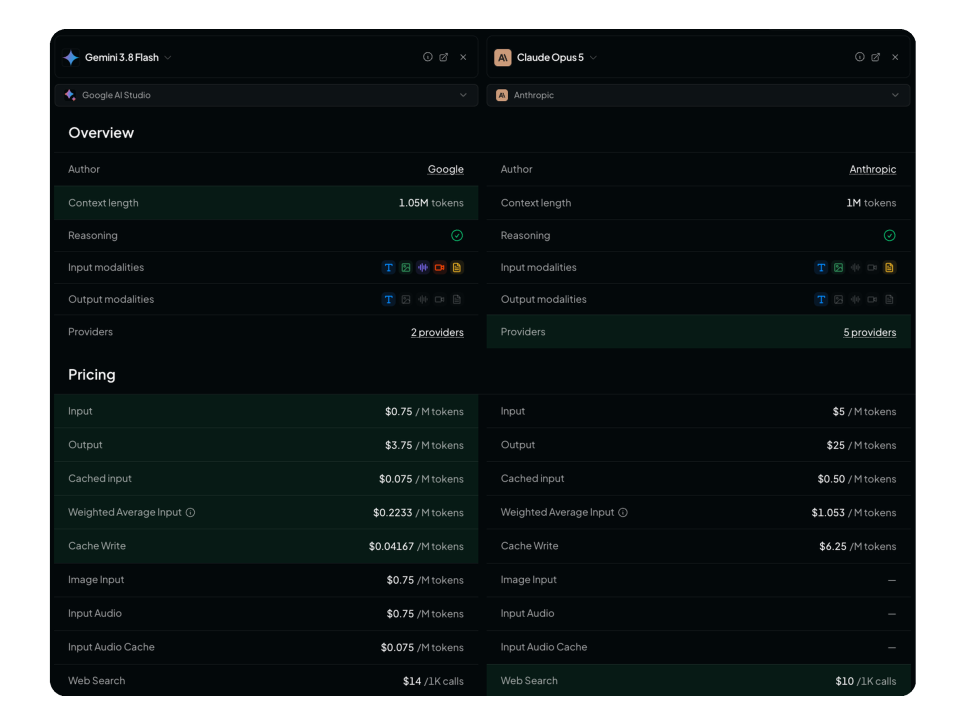
할인 기간이 끝나고 정상가로 돌아가도 Opus 5보단 훨씬 저렴하다.
실무 도입을 판단하는 기준도 달라져야 한다. 기존 챗봇처럼 답변 한 번의 품질만 비교해서는 부족하다. 완료율, 재시도 횟수, 총 출력 토큰, 첫 응답 지연을 함께 측정해야 한다.
단순 요약을 대량 처리한다면 3.7 플래시가 더 경제적일 수 있다. 반면 사람이 여러 번 개입하던 복합 작업에서는 3.8 플래시가 전체 작업 시간을 크게 줄여줄 가능성이 크다.
플래시는 세 번, 프로는 도대체 언제?
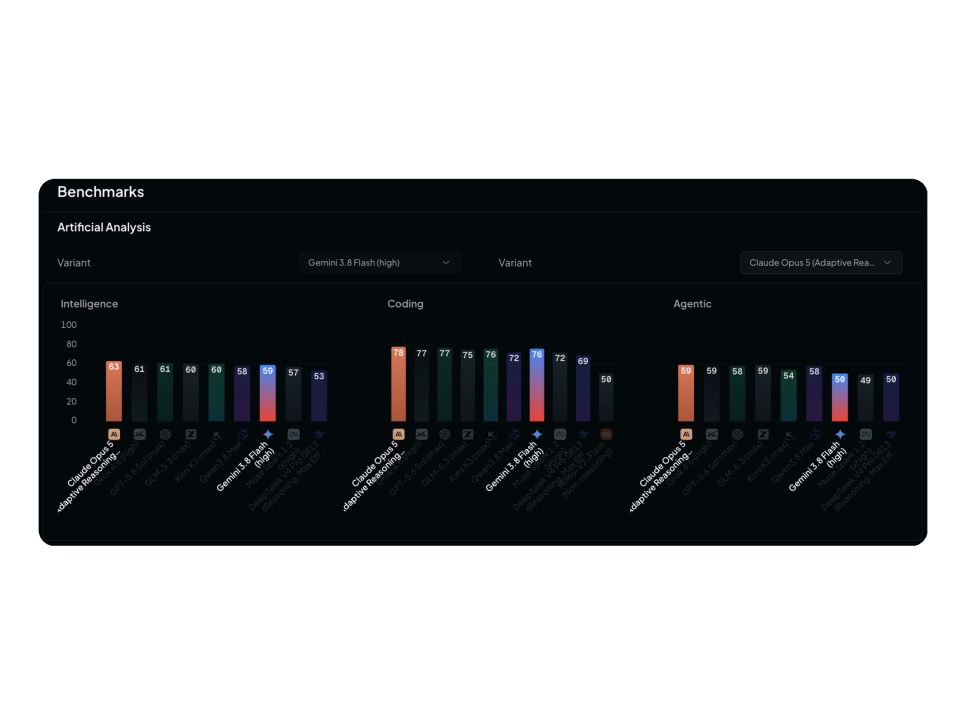
Opus 5 대비 성능은 떨어지지만, 그 차이가 상당히 좁혀졌고 무엇보다 훨씬 저렴해서 매력적이다.
지금까지 제미나이 3.8 플래시의 성능과 가격, 어디에 쓸 만한지를 정리했다. 빠른 모델의 지능이 프론티어급에 가까워지고 있다. 이건 확실히 매력적이다. 하지만 구글이 6주 동안 플래시 계열을 세 번 내놓는 사이, 6월 출시 예정이던 제미나이 3.5 프로는 끝내 나오지 않았다. 7월에는 코딩 성능 개선 때문에 수개월 밀렸다는 보도가 나왔고, 9월에는 후보 모델을 폐기하고 차세대 모델에 집중한다는 후속 보도까지 이어졌다.
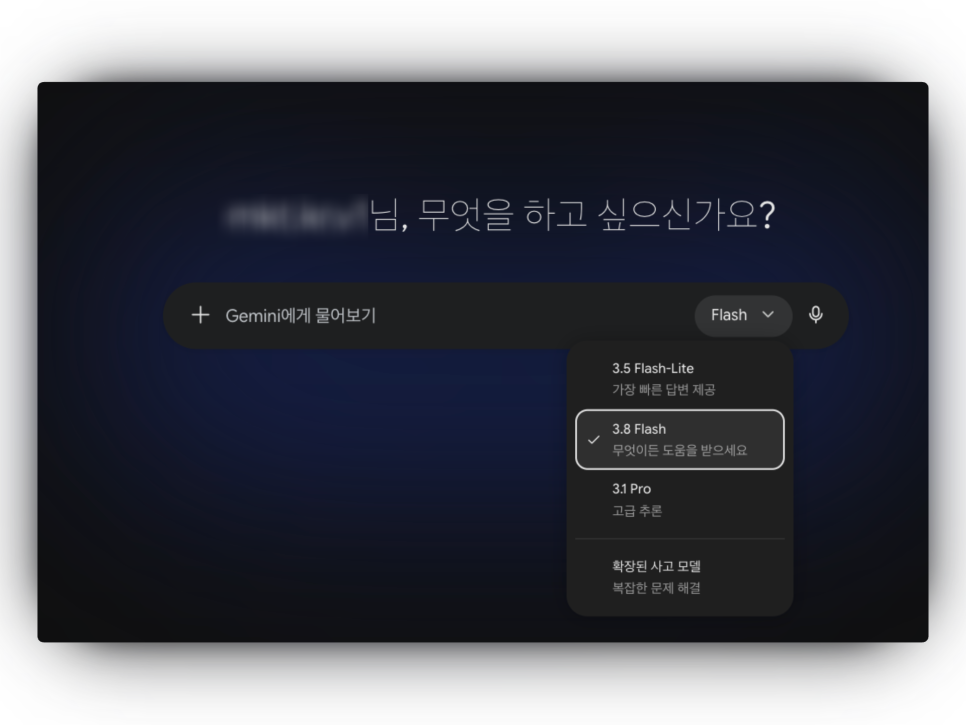
아쉬움이 남는 이유도 여기에 있다. 플래시가 어지간한 작업을 맡을 정도로 좋아졌어도 구글의 최고 추론 성능과 경쟁사의 최상위 모델을 제대로 비교하려면 결국 새 프로가 필요하다. 잦은 경량 모델 업데이트도 반갑지만 이용자가 기다린 것은 또 하나의 플래시만은 아니었다. 이름이 3.5든 차세대 버전이든, 이제는 기다림에 걸맞은 프로 모델로 답할 차례다.


댓글0